书源
摘录
标签/分类
保存为模板
关键词替换
改写/创作
续写
...
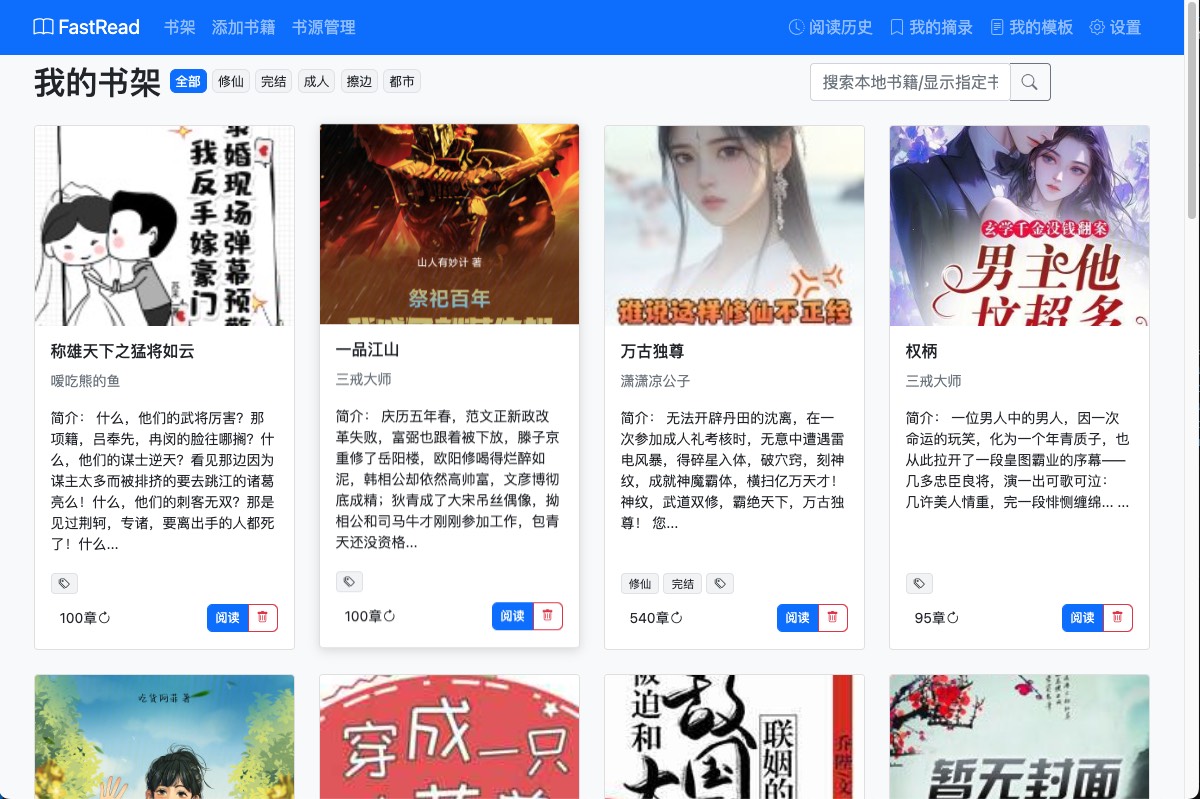
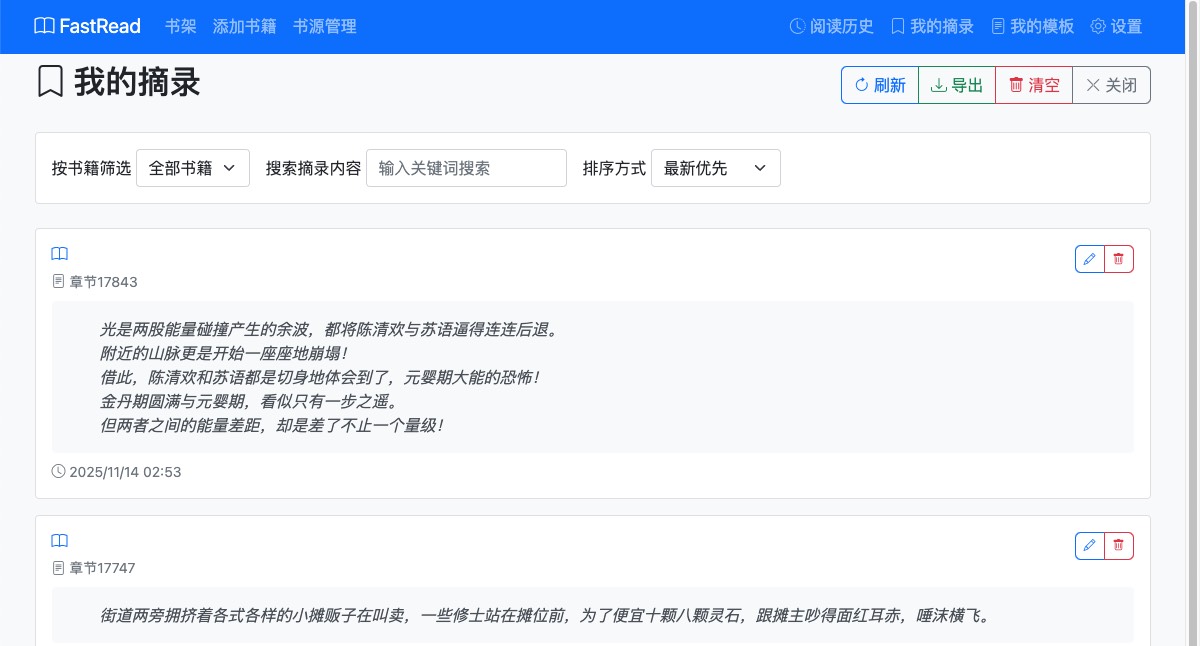
选句即存、随读随摘, 好词好句/精彩内容随心摘录。
编写模板或将精彩片段保存为模板。供改写/创作时使用。
就地改写或插入新段落,支持模板或AI创作, 当时生效;
关键词替换, 整本书生效。
断更/烂尾后自己续写; 从其他书源获取最新章节内容手动追加。
自定义添加多个书源,输入书名一键跨源搜索,找到想看的那一本。
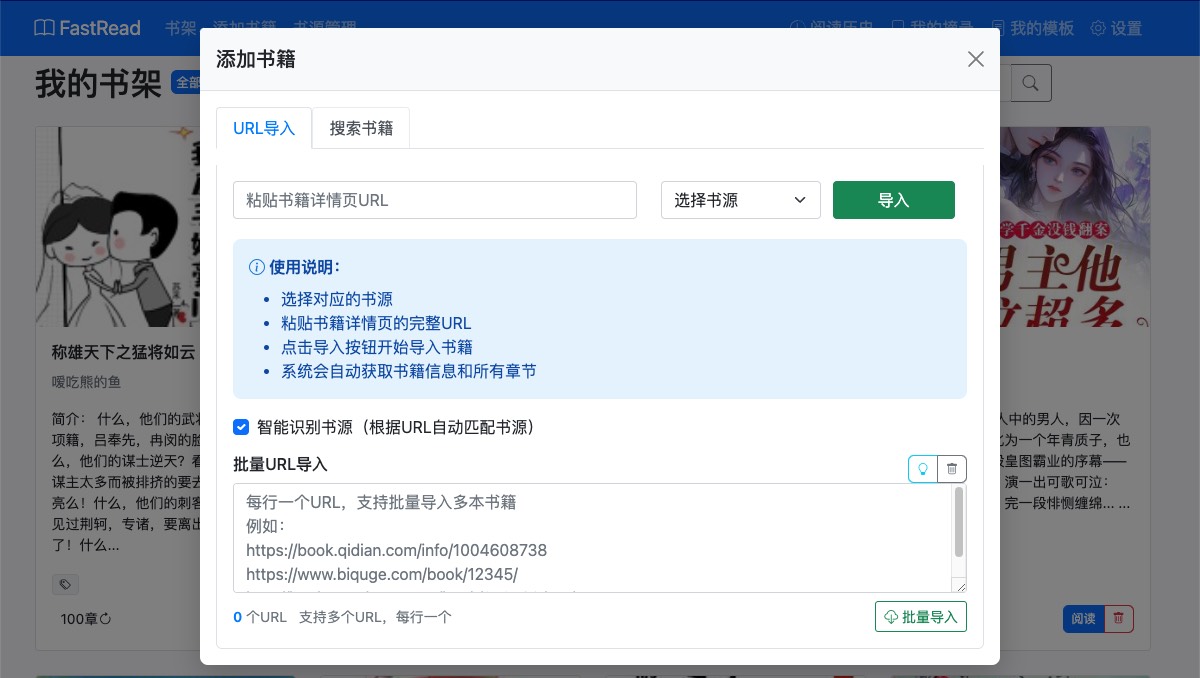
根据书籍链接自动识别书源;支持批量导入。
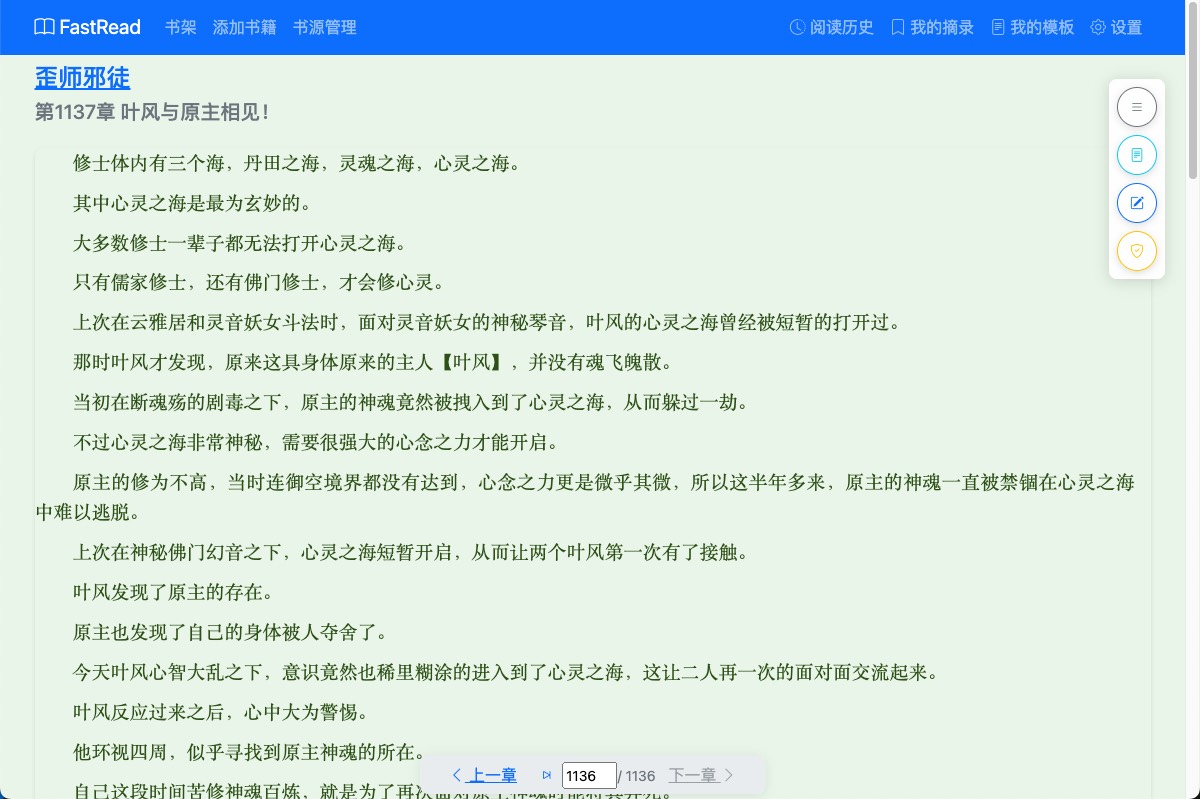
章节实时获取并自动缓存,预加载下一章节,翻页几乎无感。
自动保存与恢复阅读进度,阅读历史可随时回溯。
Windows 运行安装程序;macOS / Linux 安装桌面版后点击图标打开,或直接用 Python 启动并在浏览器访问。
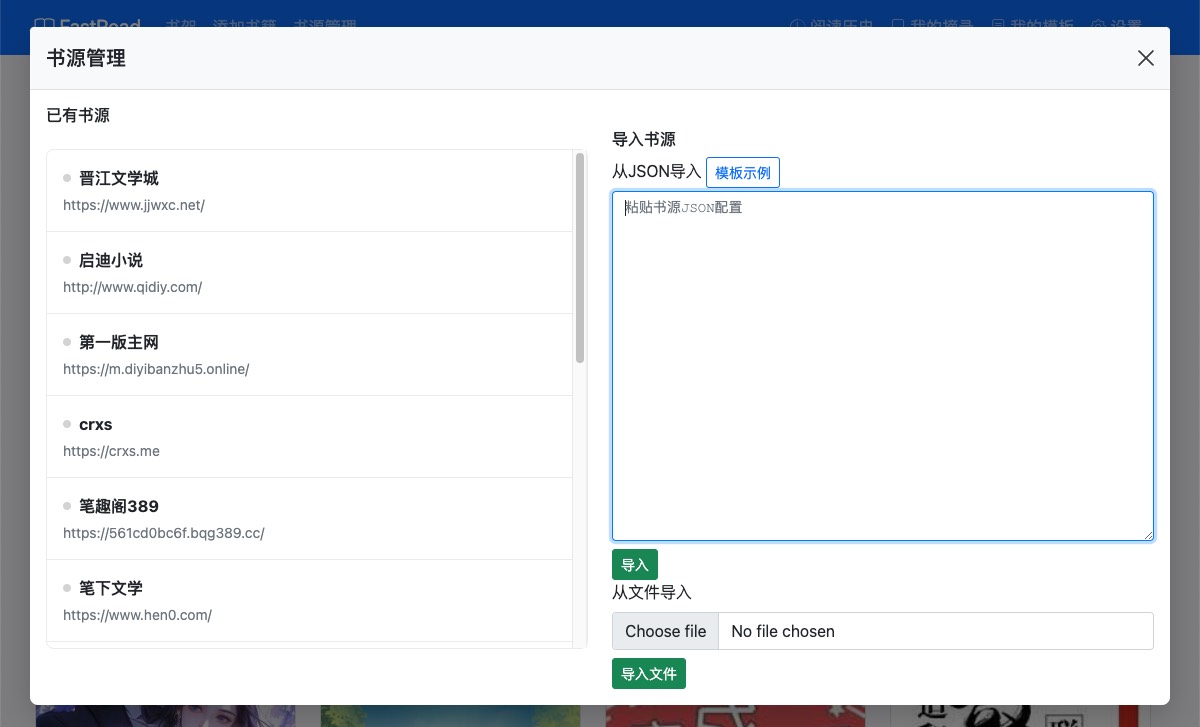
在「书源管理」页面添加、测试自己需要的书源,保存后即可使用;参考下方「书源与解析器」教程制作专属书源。
在「搜索」页输入书名,多书源一起搜;也可以输入书籍链接智能导入,或批量导入多本书籍。
打开目录选章节,用 ← / → 键切换章节;在阅读设置里设置喜欢的主题、字体和字号,进度自动保存。
对某段描写不满意,选中它让 AI 简化或扩写,还能插入自己改写的内容;
FastRead 的内容都是从不同「书源」获取的。书源解析器就是「去哪找、怎么读」的规则——告诉应用去哪个网站搜索、怎么找到书名和作者、如何获取章节正文。你可以添加别人分享的书源解析器,也可以照下面的教程为自己喜欢的网站做一个。
在「书源管理」页面直接添加: 添加 JSON 格式配置,包括网站地址、搜索地址、正文选择器等,参考示例中的格式。
对接口、加密、动态加载等特殊网站,在 sources/ 目录新建一个 .py 文件,继承解析基类后即可全自定义。
这是一些 参考示例。仅供学习交流, 下载后请在24小时内删除。
在浏览器中打开你喜欢的网站,先手动走一遍完整流程——搜一本书、打开详情页、看目录、打开正文——并用 F12 开发者工具把每类元素的 class 记下来。
在站内搜索一本已知的书,右键「检查」搜索结果里「单本书」那一项,记下它对应的选择器,例如 .search-list li。再分别打开详情页、目录页、正文页,记下书名、作者、章节链接、正文各自的 class。
name 是书源唯一标识,show_name 是界面显示的名字,url 填网站首页,domains 填该站所有域名——智能识别书籍链接时靠它匹配书源。
search.url 用 {keyword} 作为关键词占位,如 https://xxx.com/search.php?q={keyword};search.items 是列表项选择器,title / author / description 是列表项里书名、作者、简介的选择器(可写多个候选,程序取第一个命中的)。
book.title / author / description / cover_img 对应详情页元素;chapter_list.items 是目录页里章节链接的选择器,像 #list dd a。
content.selector 是正文容器;remove_tags 删除广告节点(如 .ad);remove_patterns 填正则,删掉「请记住本站域名」这类水印行;正文被拆成多页时,用 content.next 指向「下一章」/「下一节」按钮。
[
  {
    "name": "example",
    "show_name": "示例小说",
    "url": "https://www.example.com",
    "domains": ["www.example.com", "example.com"],
    "search": {
      "url": "https://www.example.com/search.php?q={keyword}",
      "items": [".search-list li"],
      "title": [".book-info h3 a"],
      "author": [".book-info p:first-of-type"]
    },
    "chapter_list": {
      "items": ["#list dd a"]
    },
    "book": {
      "title": ["#info h1"],
      "author": ["#info p:first-of-type"],
      "description": ["#intro"],
      "cover_img": ["#fmimg img"]
    },
    "content": {
      "selector": "#content",
      "remove_tags": [".ad"],
      "remove_patterns": [".*请记住本站域名.*", ".*第\\\\d+章.*"],
      "next": "#next"
    }
  }
]
保存后到「书源管理」页面点「测试」验证:先搜一本真实存在的书,再导入一本书,打开一章看正文是否干净。正文残留广告就补 remove_tags / remove_patterns;章节不全就检查 chapter_list.items;网站用了 gbk 编码可加 "encoding": "gbk"。
当网站把正文藏在接口里、或做了加密和动态加载,JSON 选择器就不够了。这时在 sources/ 目录新建一个 .py 文件,继承解析基类,覆盖需要自定义的方法:
from app.parsers.base_parser import BaseBookSourceParser

class MySiteParser(BaseBookSourceParser):
    source_config = {
        "name": "mysite",
        "show_name": "我的书站",
        "url": "https://www.mysite.com",
        "domains": ["www.mysite.com"],
    }

    async def get_chapter_content(self, chapter_url):
        # 正文藏在接口里?在这里请求接口、解密、返回纯文本
        ...
常用可覆盖方法:search_books / get_book_info / get_chapter_list / get_chapter_content / parse_chapter_content / parse_chapter_list。参考示例中里现有解析器即可快速上手。